Uncategorized
Bảo mật ChatGPT Work: Dữ liệu, quyền truy cập và governance
22
Th8
Th8
Bảo mật ChatGPT Work: Dữ liệu, quyền truy cập và governance
Một marketer đưa research khách hàng lên ChatGPT. Một nhân viên kết nối Google Drive. Một team tạo GPT dùng tài liệu nội bộ. Xa hơn nữa, một AI Agent được cấp quyền đọc hoặc thay đổi dữ liệu trong ứng dụng khác.
Lúc này, câu hỏi bảo mật không còn đơn giản là “ChatGPT có lưu dữ liệu không?”.
Để đánh giá một workflow AI có đủ an toàn để đưa vào công việc hay không, tôi thấy cách hữu ích hơn là lần theo toàn bộ chuỗi:
Dữ liệu nào đi vào → dữ liệu được xử lý/lưu thế nào → ai có quyền truy cập → AI/app có thể làm gì → hành động nào cần người kiểm tra.
Bài này không cố đưa ra kết luận kiểu “ChatGPT Work an toàn” hay “không an toàn”. Thay vào đó, chúng ta sẽ xây một framework thực tế để Admin, team lead và doanh nghiệp có thể quyết định dữ liệu nào được phép đưa vào ChatGPT, ai được dùng tính năng nào và AI được phép hành động đến đâu.

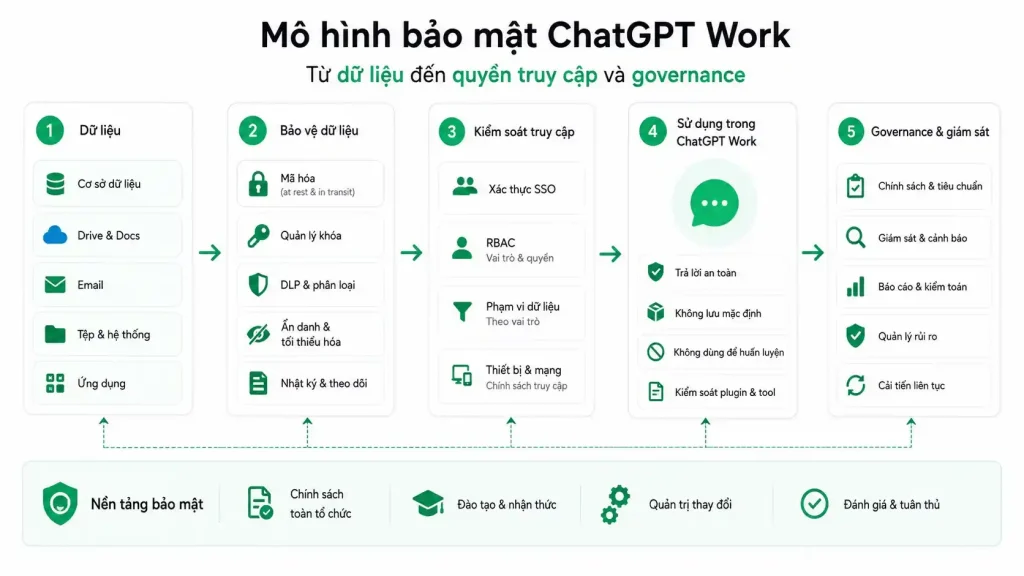
Bảo mật ChatGPT Work không phải một setting đơn lẻ mà là chuỗi Data → Identity → Permission → Action → Audit.
ChatGPT Work có bảo mật không?
ChatGPT dành cho doanh nghiệp có nhiều lớp kiểm soát về dữ liệu, danh tính và quyền truy cập, nhưng điều đó không có nghĩa mọi workflow sử dụng ChatGPT đều tự động an toàn.
Theo tài liệu chính thức của OpenAI, dữ liệu từ các sản phẩm business như ChatGPT Business, Enterprise và Edu không được dùng để huấn luyện model theo mặc định. OpenAI cũng công bố dữ liệu được mã hóa khi lưu trữ và khi truyền tải. Bạn có thể kiểm tra trực tiếp tại Business data privacy, security, and compliance và Enterprise privacy at OpenAI.
Nhưng đây mới chỉ là security ở tầng nền tảng.
Trong một workflow thực tế, rủi ro còn phụ thuộc vào nhiều thứ khác:
- workspace và gói ChatGPT đang sử dụng;
- loại dữ liệu người dùng nhập;
- thời gian lưu giữ dữ liệu;
- ai được tham gia workspace;
- ai được chia sẻ GPT, Project hoặc nội dung;
- app nào được kết nối;
- app chỉ được đọc hay còn có quyền ghi dữ liệu;
- AI có được phép thực hiện hành động bên ngoài ChatGPT hay không;
- admin đã cấu hình những control nào;
- và bước nào vẫn bắt buộc con người kiểm tra.
Vì vậy, một nguyên tắc quan trọng của bài này là:
Security của nền tảng là một lớp. Governance quyết định tổ chức sử dụng lớp bảo mật đó như thế nào.
Privacy, security và governance khác nhau thế nào?
| Khái niệm | Câu hỏi chính | Ví dụ |
|---|---|---|
| Privacy | Dữ liệu của tôi được sử dụng thế nào? | Dữ liệu business có được dùng để train model hay không? |
| Security | Dữ liệu và hệ thống được bảo vệ thế nào? | Mã hóa, SSO, authentication, network controls |
| Governance | Ai được làm gì, với dữ liệu nào và theo quy trình nào? | Marketing được dùng Drive nhưng intern không được publish WordPress |
Ba khái niệm này thường bị gom lại thành một câu hỏi “ChatGPT có an toàn không?”. Nhưng với doanh nghiệp, “không dùng dữ liệu để train” không đồng nghĩa “không còn rủi ro”.
Dữ liệu đi đâu khi bạn dùng ChatGPT Work?
Một cách dễ hiểu hơn việc đọc từng trang Privacy Policy là nhìn ChatGPT theo data lifecycle: dữ liệu được tạo ở đâu, đi qua đâu, được lưu ở đâu và khi nào được xóa.
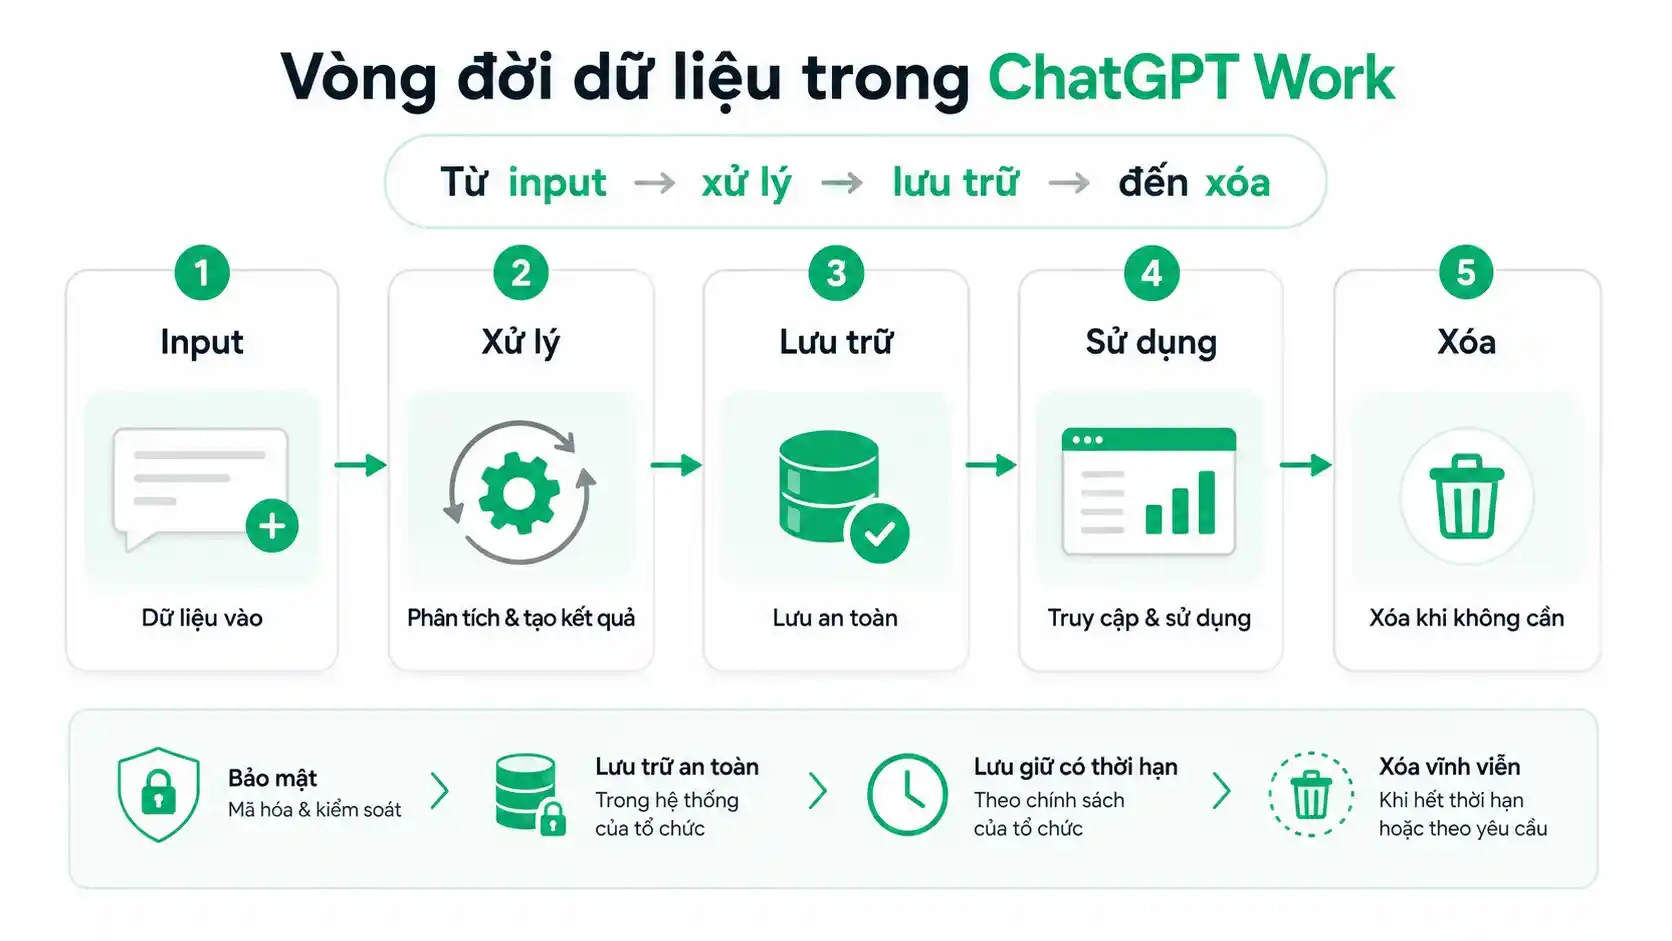
Một cách thực tế để review bảo mật là theo dõi dữ liệu từ lúc nhập vào ChatGPT cho tới khi được lưu, chia sẻ, audit hoặc xóa.
1. Input: bạn đang đưa loại dữ liệu gì vào ChatGPT?
Input không chỉ là prompt.
Trong một workspace làm việc, dữ liệu có thể đến từ:
- prompt người dùng nhập;
- file upload;
- spreadsheet hoặc tài liệu;
- dữ liệu từ Google Drive, SharePoint hoặc ứng dụng kết nối;
- context từ Project;
- GPT riêng của tổ chức;
- memory nếu tính năng này được bật;
- kết quả từ workflow hoặc agent trước đó.
Đây là lý do data policy nên bắt đầu bằng câu hỏi “AI được phép nhìn thấy gì?”, chứ không phải “nhân viên được phép dùng ChatGPT hay không?”.
2. Processing: model vẫn phải xử lý dữ liệu để tạo output
Một misconception khá phổ biến là:
“OpenAI không dùng dữ liệu business để train, vậy dữ liệu không được xử lý.”
Hai việc này khác nhau.
No training không đồng nghĩa no processing. Model vẫn cần nhận và xử lý nội dung cần thiết để tạo câu trả lời hoặc thực hiện tác vụ mà người dùng yêu cầu.
Đây cũng là nơi cần phân biệt:
- data at rest: dữ liệu khi được lưu;
- data in transit: dữ liệu khi truyền qua mạng;
- inference: quá trình model xử lý input để tạo kết quả.
3. Data residency không phải lúc nào cũng đồng nghĩa inference residency
Đây là một chi tiết đặc biệt quan trọng nếu doanh nghiệp có yêu cầu dữ liệu phải nằm hoặc được xử lý trong một khu vực địa lý cụ thể.
Theo tài liệu OpenAI hiện hành, data residency cho phép nội dung thuộc phạm vi hỗ trợ được lưu at rest trong khu vực chỉ định. Inference residency là một capability riêng, dành cho các khách hàng đủ điều kiện và các khu vực được hỗ trợ, nhằm giữ model inference trong khu vực đó.
Nói cách khác, không nên thấy cụm “data residency” rồi tự suy luận rằng toàn bộ quá trình xử lý dữ liệu cũng mặc định diễn ra ở cùng khu vực.
Nếu đây là yêu cầu compliance của tổ chức, hãy kiểm tra tài liệu hiện hành tại Data residency and inference residency for ChatGPT.
4. ChatGPT lưu dữ liệu trong bao lâu?
Không có một con số retention duy nhất áp dụng cho mọi loại workspace, mọi feature và mọi tình huống.
Ví dụ, tài liệu OpenAI hiện hành cho biết việc một user bị remove khỏi Enterprise/Edu sẽ tuân theo retention policy của workspace. Với ChatGPT Business, chats, files và một số nội dung workspace của thành viên bị remove hiện được mô tả là được giữ vô thời hạn và có thể khôi phục nếu user được thêm lại.
Điều này dẫn tới một lesson thực tế:
Remove user không phải lúc nào cũng đồng nghĩa delete data.
Vì retention có thể thay đổi theo workspace và feature, nên trước khi rollout hãy kiểm tra hai tài liệu chính thức: Data retention when a member is removed from a workspace và Chat and File Retention Policies in ChatGPT.
5. OpenAI có dùng dữ liệu doanh nghiệp để train model không?
Theo chính sách hiện hành, OpenAI không sử dụng dữ liệu từ ChatGPT Business, Enterprise và các sản phẩm business được liệt kê để huấn luyện model theo mặc định.
Đây là một control quan trọng, nhưng không nên biến nó thành shorthand cho toàn bộ bài toán bảo mật.
Hãy tách bốn câu hỏi:
No training ≠ no processing ≠ no storage ≠ no third-party risk.
Khi team bắt đầu kết nối ChatGPT với Google Drive, CRM, CMS hoặc custom app, bạn đã có thêm trust boundary ngoài chính nền tảng OpenAI.
Ai có thể xem và truy cập dữ liệu trong workspace?
Sau Data là Identity và Access.
Một workspace doanh nghiệp không nên vận hành theo logic:
“Ai đã vào workspace thì được dùng mọi thứ.”
Thay vào đó, quyền nên bám vào job mà mỗi nhóm thực sự cần hoàn thành.
Workspace chung không có nghĩa mọi người tự động nhìn thấy mọi chat
Việc một người là thành viên workspace không đồng nghĩa họ tự động có quyền đọc toàn bộ lịch sử chat riêng của tất cả thành viên khác.
Tuy nhiên, tổ chức có thể có các capability quản trị, compliance và logging khác nhau tùy plan. Với managed account, OpenAI cũng cung cấp thông tin riêng về những gì administrator có thể kiểm soát hoặc truy cập.
Nếu đây là vấn đề nhạy cảm trong policy nhân viên, nên tham chiếu trực tiếp tài liệu Data access for your managed ChatGPT account thay vì suy đoán dựa trên trải nghiệm tài khoản cá nhân.
Owner, Admin, Analytics Viewer và Member khác nhau thế nào?
Theo tài liệu ChatGPT Business hiện hành, workspace có bốn built-in roles. OpenAI cũng mô tả bốn role tương ứng trong Enterprise/Edu.
| Role | Mục đích | Điểm cần chú ý |
|---|---|---|
| Owner | Quản trị workspace cấp cao | Billing, identity management, workspace configuration |
| Admin | Quản trị vận hành | User, group và các tác vụ admin thường ngày |
| Analytics Viewer | Xem workspace analytics | Không nên nhầm với quyền quản trị toàn bộ workspace |
| Member | Sử dụng ChatGPT phục vụ công việc | Không có admin privilege mặc định |
Bạn có thể kiểm tra role hiện hành của Business tại Managing members, seat types, and roles in ChatGPT Business.
Role quản trị và RBAC không phải một thứ
Đây là một điểm đáng chú ý.
Owner/Admin/Member chủ yếu trả lời câu hỏi “ai có quyền quản trị workspace?”.
Trong khi đó, Member RBAC ở những workspace được hỗ trợ trả lời một câu hỏi khác:
“Nhóm người dùng này được phép sử dụng capability nào?”
OpenAI hiện mô tả Member RBAC cho ChatGPT Enterprise là cơ chế cho phép workspace owner tạo custom role để kiểm soát quyền truy cập end-user vào tools, trong khi các role như Owner/Admin/Member vẫn quản lý quyền ở tầng workspace.
Chi tiết nên luôn được kiểm tra theo plan tại Role Based Access Controls for ChatGPT Enterprise.

Permission matrix mẫu: không phải mọi người trong workspace đều cần cùng một tập quyền.
Ví dụ: thiết kế permission theo JOB thay vì theo phòng ban chung chung
Một team Marketing có thể cần Search và Google Drive để research.
Finance có thể cần phân tích file nhưng không cần quyền publish nội dung.
Một intern có thể chỉ cần chat, research và draft mà không cần write action tới hệ thống production.
Điểm quan trọng ở đây là least privilege: cấp đủ quyền để hoàn thành job, không cấp toàn bộ capability chỉ vì “sau này có thể cần”.
Nếu bạn đang xây policy chi tiết hơn cho tầng này, xem tiếp bài quyền truy cập và phê duyệt trong ChatGPT Work. Phần đó nên được dùng để đi sâu vào permission design, thay vì lặp lại toàn bộ security framework ở bài hiện tại.
Rủi ro tăng lên khi ChatGPT được kết nối với dữ liệu và ứng dụng
Đây là nơi ChatGPT chuyển từ một chatbot thành một phần của hệ thống làm việc.
Một chat đơn giản có thể hình dung như:
User → Prompt → Model → Answer
Nhưng khi kết nối ứng dụng:
User → ChatGPT → App → Internal Data → Action → External System
Khi AI chỉ tạo câu trả lời, blast radius tương đối hạn chế. Khi AI có thể tìm dữ liệu nội bộ, sửa spreadsheet, tạo issue hoặc thực hiện write action, permission design trở thành một phần của security.

Mỗi app mở rộng khả năng của workflow nhưng đồng thời tạo thêm một trust boundary cần quản lý.
App có bỏ qua quyền hiện có ở Google Drive hoặc nguồn dữ liệu không?
Với các app hỗ trợ sync, OpenAI mô tả hệ thống là tôn trọng permission hiện có ở nguồn dữ liệu. Nói đơn giản, user không nên nhận quyền với tài liệu chỉ vì ChatGPT được kết nối nếu chính user vốn không có quyền ở hệ thống nguồn.
Tuy nhiên, điều đó không loại bỏ nhu cầu review cấu hình.
Admin vẫn nên kiểm tra:
- app nào được enable;
- user nào được phép kết nối;
- account nào đang authenticate;
- scope và capability của app;
- dữ liệu nào được sync;
- app chỉ search/read hay còn hỗ trợ write;
- action nào yêu cầu confirmation.
OpenAI cập nhật khá thường xuyên hệ thống Apps, vì vậy nên dùng Apps in ChatGPT và ChatGPT apps with sync làm source of truth tại thời điểm triển khai.
Read access và write action là hai mức rủi ro khác nhau
Hãy tách hai scenario:
Read: “Tìm file kế hoạch Q3 và tóm tắt ba rủi ro chính.”
Write: “Cập nhật trạng thái dự án, tạo issue và thay đổi dữ liệu trong hệ thống.”
Hai workflow có thể dùng cùng một app nhưng risk profile hoàn toàn khác nhau.
Tài liệu Apps hiện hành của OpenAI có cơ chế App permissions để xác định khi nào ChatGPT cần hỏi người dùng trước khi sử dụng app hoặc thực hiện action. Với MCP app có khả năng sửa dữ liệu, confirmation còn phụ thuộc vào permission, context và mức tác động của action.
Đây là lý do tôi không khuyên dùng một policy duy nhất kiểu “app này được phép / app này bị cấm”.
Policy tốt hơn cần xuống tới mức:
App → capability → read/write → user group → approval requirement.
Custom MCP app mở thêm trust boundary
MCP và custom apps giúp ChatGPT kết nối với hệ thống doanh nghiệp theo những cách linh hoạt hơn. Nhưng đổi lại, tổ chức cần đánh giá thêm server bên ngoài, authentication, permission scope, data flow và khả năng prompt injection.
OpenAI cũng cảnh báo developer mode và MCP app có những rủi ro riêng, đặc biệt khi tool có khả năng thực hiện write hoặc modify action. Xem hướng dẫn hiện hành tại Developer mode and MCP apps in ChatGPT.
Nếu bạn đang ở giai đoạn thiết kế nguồn dữ liệu thay vì policy tổng thể, xem thêm ChatGPT Connectors: kết nối dữ liệu và ứng dụng an toàn.
Framework 5 lớp để quản trị ChatGPT Work an toàn
Thay vì bắt đầu bằng một tài liệu policy dài hàng chục trang, tôi đề xuất map từng workflow qua 5 lớp:
DATA → IDENTITY → PERMISSION → ACTION → AUDIT

Framework governance 5 lớp: DATA → IDENTITY → PERMISSION → ACTION → AUDIT.
Lớp 1 — DATA: AI được phép thấy gì?
Đầu tiên, phân loại dữ liệu thay vì để nhân viên tự quyết định trong từng prompt.
| Nhóm dữ liệu | Ví dụ | Policy gợi ý |
|---|---|---|
| Public | Website công khai, SERP, tài liệu public | Allow |
| Internal | Brief SEO, SOP nội bộ, kế hoạch content | Allow theo workspace/policy |
| Confidential | Dữ liệu khách hàng, chiến lược chưa công bố | Review trước khi sử dụng |
| Restricted | Password, API secret, credential nhạy cảm | Không đưa vào workflow thông thường |
Bảng trên là framework gợi ý, không phải chuẩn pháp lý. Mỗi tổ chức cần map lại theo data classification, hợp đồng, quy định ngành và yêu cầu pháp lý của mình.
Lớp 2 — IDENTITY: ai đang sử dụng?
Trước khi nói tới AI Agent, hãy xử lý identity hygiene cơ bản:
- dùng managed/company account khi phù hợp;
- quản lý lời mời vào workspace;
- review Owner và Admin định kỳ;
- có onboarding/offboarding rõ ràng;
- remove user khi không còn cần quyền;
- dùng SSO hoặc các identity control tương ứng với nhu cầu và plan.
Security phức tạp thường thất bại vì những vấn đề rất đơn giản: account cũ vẫn còn quyền, shared credential hoặc nhóm user không được cập nhật.
Lớp 3 — PERMISSION: user và AI được quyền làm gì?
Áp dụng nguyên tắc:
Đủ quyền để hoàn thành job, không đủ quyền để tạo blast radius không cần thiết.
Ví dụ, một SEO researcher có thể cần Search + Drive read. Người phụ trách publishing có thể cần CMS draft. Chỉ một nhóm nhỏ thực sự cần quyền publish production.
Đây là chỗ permission matrix có giá trị hơn một câu policy kiểu “được phép dùng AI”.
Lớp 4 — ACTION: việc gì AI được tự làm?
Tôi thường thấy dễ triển khai hơn nếu chia action thành ba mức:
| Mức | Cách xử lý | Ví dụ |
|---|---|---|
| Green | Có thể tự động | Research public data, summarize, draft |
| Yellow | Cần review tùy workflow | Cập nhật draft, phân tích internal document |
| Red | Human approval trước action | Publish, delete, send externally, thay đổi permission, financial action |
Đây không phải classification do OpenAI quy định. Đây là framework quản trị gợi ý để team chuyển từ “AI có làm được không?” sang “AI có được phép tự làm không?”.
Lớp 5 — AUDIT: sau khi workflow chạy, bạn kiểm tra được gì?
Governance không kết thúc ở approval.
Team cần trả lời:
- ai chịu trách nhiệm review workflow;
- có log nào để điều tra khi có sự cố;
- quyền được review lại theo chu kỳ nào;
- có cần đẩy event/log sang SIEM, DLP hoặc eDiscovery không;
- retention nội bộ cần dài bao lâu.
Với ChatGPT Enterprise/Edu, OpenAI cung cấp OpenAI Compliance Platform. Tài liệu hiện hành cho biết Compliance Logs Platform giữ dữ liệu trong 30 ngày; nếu cần retention dài hơn, tổ chức cần triển khai cơ chế tải log liên tục và lưu theo policy riêng.
Đây là một chi tiết nhỏ nhưng rất quan trọng: “có audit log” không đồng nghĩa “log sẽ tồn tại đủ lâu cho yêu cầu của bạn”.
Risk Register mẫu trước khi đưa một AI workflow vào sử dụng
Không phải team nào cũng cần một hệ thống GRC phức tạp ngay ngày đầu tiên.
Với một workflow mới, bạn có thể bắt đầu bằng sáu cột:
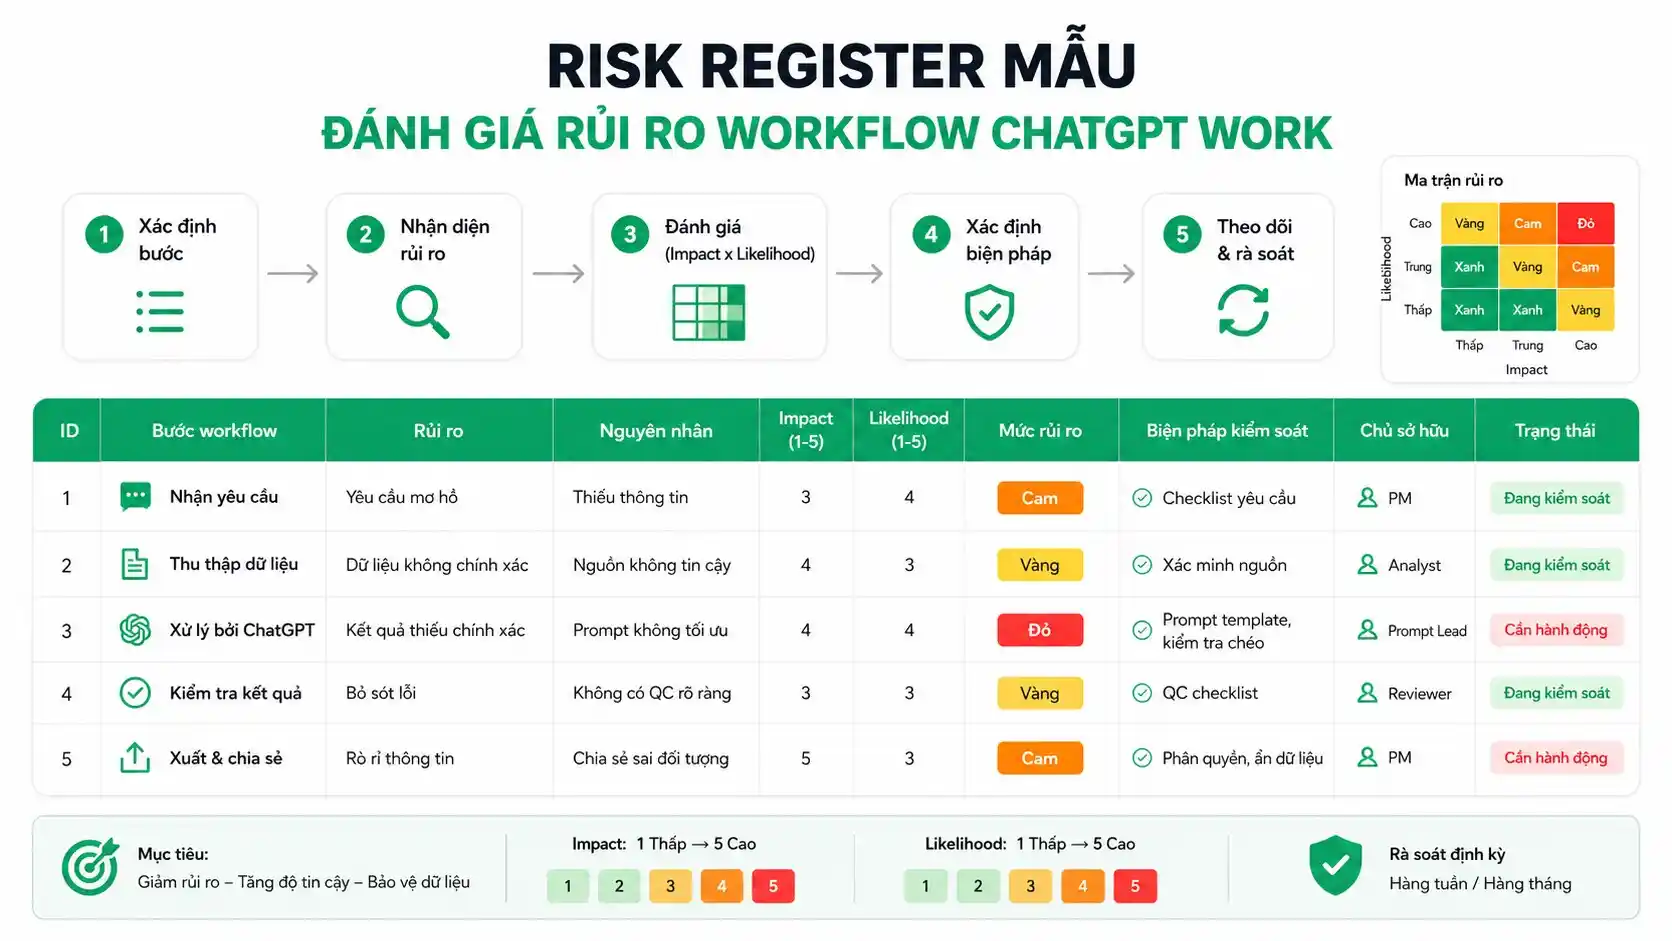
Risk Register đơn giản giúp đánh giá dữ liệu, quyền, hành động, mức rủi ro và control trước khi rollout workflow.
| Workflow | Data | Access | Action | Risk | Control |
|---|---|---|---|---|---|
| Research SEO | Public web | Search | Read | Low | Source QA |
| Phân tích Google Drive | Internal docs | Drive | Read | Medium | Group + least privilege |
| Soạn bài WordPress | Internal + public | CMS | Draft | Medium | Human review |
| Publish WordPress | Public content | CMS | Write/publish | High | Approval before publish |
| Phân tích khách hàng | Customer data | CRM | Read | High | Data policy + restricted access |
Risk level trong bảng là ví dụ để minh họa phương pháp, không phải universal rating.
Điểm quan trọng là trước khi nói “cho AI chạy thử”, team phải chỉ ra được ít nhất:
AI đang dùng dữ liệu gì? Có quyền gì? Có thể gây thay đổi gì? Và control nào ngăn một lỗi nhỏ biến thành lỗi production?
Ví dụ thực tế: governance cho workflow Content SEO dùng ChatGPT
Để framework này bớt lý thuyết, hãy lấy một workflow Content SEO làm ví dụ.
Một workflow có thể đi theo chuỗi:
Keyword → Research → Outline → Draft → Image → Internal Link → WordPress
Nếu chỉ nhìn ở tầng “AI viết content”, rủi ro có vẻ không lớn.
Nhưng khi nối sang WordPress, workflow đã đi từ content generation sang external action.
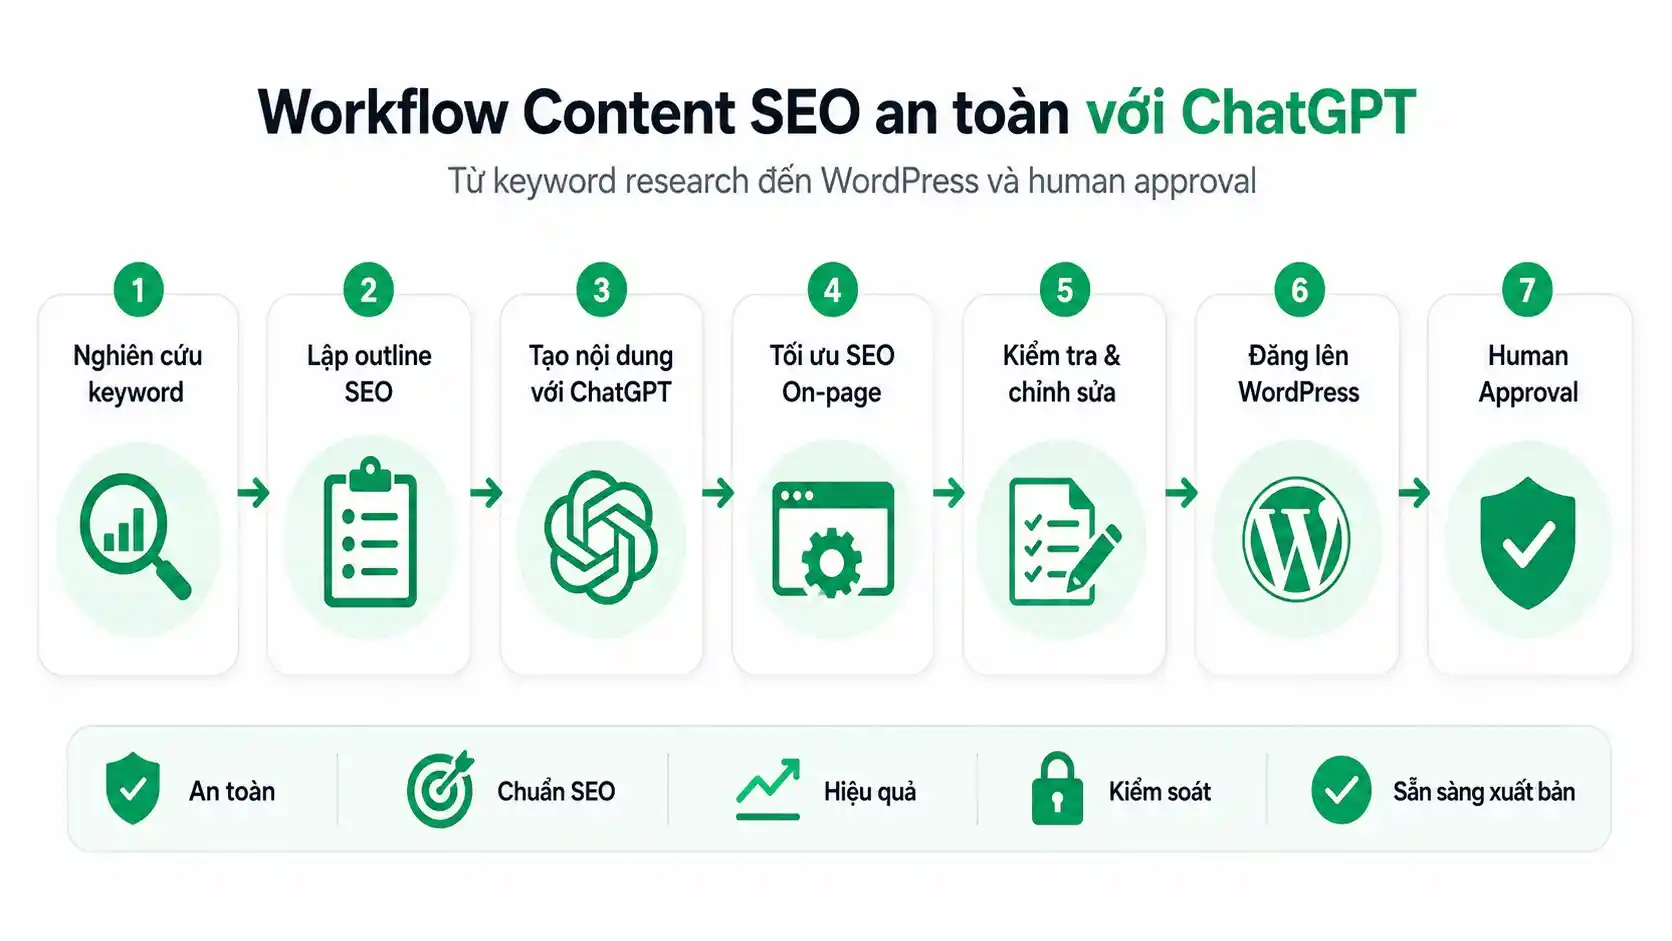
Ví dụ governance cho workflow SEO: AI có thể xử lý nhiều bước nhưng production publish vẫn có checkpoint kiểm duyệt.
Map workflow qua các checkpoint
Input: keyword, website, audience, source material.
Research: public sources có thể được tự động thu thập, nhưng nguồn và ngày cập nhật vẫn cần QA.
Internal context: nếu đưa brief hoặc tài liệu nội bộ vào workflow, kiểm tra data classification trước.
Draft: AI có thể tạo nội dung nhưng không nên mặc định coi output là fact đã xác minh.
CMS: nếu có thể, tách quyền tạo Draft khỏi quyền Publish.
Production: publication có thể là Red action nếu sai nội dung có thể ảnh hưởng brand, traffic, legal claim hoặc website production.
Workflow Content SEO để bạn xem cách automation chạy thực tế
AIWorkflowFree có GPT-AI Writer / workflow Content SEO để bạn hình dung rõ hơn cách một input có thể đi qua nhiều bước rồi tạo thành bài viết và output cho website.
Nếu muốn xem demo thay vì chỉ đọc flow trên giấy, video Tạo 100+ Content SEO Chỉ Với 1 Click | Tự Động ChatGPT trên kênh Duy Thìn cho thấy workflow automation Content SEO và GPT-AI Writer trong thực tế.
Lưu ý: video trên là bằng chứng về workflow automation, không phải một security benchmark. Phần governance trong bài này là lớp cần bổ sung khi workflow được đưa vào môi trường có dữ liệu nội bộ, quyền CMS hoặc nhiều user.
Human review vẫn giải quyết một bài toán khác: chất lượng output
Bảo mật không phải rủi ro duy nhất.
Ngay cả khi permission được cấu hình đúng, AI vẫn có thể tạo output thiếu nguồn, hiểu sai context hoặc đưa ra claim chưa được xác minh.
Video Cách Tối Ưu Viết Content AI: ChatGPT + Perplexity AI là ví dụ phù hợp để xem cách bổ sung research và QA vào workflow Content SEO.
Nếu cần đi sâu riêng vào quality control, đọc tiếp cách kiểm tra đầu ra ChatGPT Work. Security governance và output QA là hai lớp khác nhau nhưng đều cần nếu muốn đưa AI vào production.
Checklist 15 phút trước khi cho team dùng ChatGPT Work
Không cần đợi đến khi có một policy hoàn hảo mới bắt đầu kiểm soát rủi ro. Với một team nhỏ, checklist dưới đây đã đủ để tìm ra phần lớn lỗ hổng rõ ràng trước rollout.
Data
- ☐ Đã xác định loại dữ liệu nào được phép nhập vào AI?
- ☐ Đã xác định dữ liệu nào không được phép nhập?
- ☐ Đã kiểm tra retention requirement?
- ☐ Đã kiểm tra data/inference residency nếu tổ chức yêu cầu?
Identity
- ☐ User có dùng account thuộc tổ chức?
- ☐ Có onboarding và offboarding rõ ràng?
- ☐ Owner/Admin đã được giới hạn hợp lý?
- ☐ User không còn nhu cầu đã được remove?
Permissions
- ☐ Apps nào thực sự cần bật?
- ☐ Quyền đã theo least privilege?
- ☐ GPT/Project/app sharing scope đã được review?
- ☐ Read và write permissions đã được phân biệt?
Actions
- ☐ Action nào AI được tự thực hiện?
- ☐ Action nào bắt buộc human approval?
- ☐ Publish/delete/send/update nhạy cảm đã có checkpoint?
Audit
- ☐ Ai chịu trách nhiệm review workflow?
- ☐ Có log phù hợp với mức rủi ro?
- ☐ Permission được review lại theo chu kỳ nào?
- ☐ Incident xảy ra thì ai là owner?
Nếu bạn chuẩn bị rollout cho nhiều phòng ban thay vì một workflow đơn lẻ, bước tiếp theo hợp lý là checklist triển khai ChatGPT Work cho doanh nghiệp.
ChatGPT Business hay Enterprise: khác biệt nào đáng quan tâm về governance?
Không nên rút gọn câu hỏi này thành “Enterprise an toàn, Business không an toàn”.
Cả hai đều có các cam kết business-data quan trọng như dữ liệu không được dùng train model theo mặc định và mã hóa dữ liệu. Nhưng Enterprise được thiết kế cho những tổ chức cần các lớp control sâu hơn.
| Nhu cầu | Business | Enterprise |
|---|---|---|
| Dữ liệu business không dùng train mặc định | Có | Có |
| Encryption at rest/in transit | Có | Có |
| Workspace/admin controls | Có | Có, sâu hơn |
| Identity/SSO | Có control dành cho business | Có enterprise identity controls |
| Custom Member RBAC | Kiểm tra capability hiện hành theo plan | Có tài liệu Member RBAC riêng |
| Compliance Logs Platform | Không phải capability mặc định được mô tả cho Business | Enterprise/Edu |
| Retention tùy chỉnh | Hạn chế hơn | Có workspace retention controls theo cấu hình |
| Enterprise security controls | Hạn chế hơn | Có thêm các control như IP allowlisting, EKM và các capability enterprise khác khi đủ điều kiện |
Lưu ý: OpenAI thay đổi feature và entitlement khá nhanh. Nếu một control là requirement bắt buộc cho procurement hoặc compliance, hãy kiểm tra lại tài liệu plan tại thời điểm mua thay vì sử dụng bảng trên như hợp đồng tính năng.
Có thể bắt đầu từ ChatGPT Business và ChatGPT Enterprise Admin Quickstart.
7 lỗi governance dễ gặp khi triển khai ChatGPT
1. Nghĩ “không train dữ liệu” đồng nghĩa “không cần data policy”
No-training là một privacy commitment quan trọng. Nó không thay thế data classification, permission design hay quy định nội bộ về confidential data.
2. Cho tất cả user cùng một quyền
Marketer, intern, finance và admin không thực hiện cùng một JOB. Vì vậy không có lý do để mặc định họ cần cùng capability.
3. Kết nối app nhưng không review capability
Biết tên app chưa đủ. Cần biết app được đọc gì, ghi gì, user authenticate bằng account nào và action nào cần confirmation.
4. Không phân biệt read với write
“Tìm file” và “sửa file” không có cùng blast radius. Đây là một trong những distinction quan trọng nhất khi AI bắt đầu kết nối với hệ thống bên ngoài.
5. Cho AI publish, send hoặc delete mà không có approval
Automation tốt không có nghĩa loại bỏ con người khỏi mọi bước. Với action có hậu quả khó đảo ngược, human checkpoint có thể là feature của workflow chứ không phải điểm yếu.
6. Không có offboarding
User rời tổ chức nhưng account, group hoặc app permission không được review là một lỗi identity governance cơ bản. Đồng thời, cần hiểu rõ removal và content deletion là hai việc khác nhau.
7. Chỉ kiểm tra input mà bỏ qua output
Một workflow có thể bảo vệ dữ liệu đúng nhưng vẫn tạo claim sai, nguồn cũ hoặc nội dung không phù hợp để publish. Vì vậy security review và output QA phải chạy song song.
Một AI Usage Policy đơn giản nên có gì?
Nếu bạn là SME hoặc team nhỏ, không nhất thiết bắt đầu bằng một tài liệu policy 30 trang.
Một phiên bản một trang có thể chứa tám phần:
- Scope: ai thuộc phạm vi áp dụng.
- Approved use cases: AI được dùng cho những JOB nào.
- Data rules: dữ liệu nào được và không được đưa vào.
- Approved tools/apps: hệ thống nào đã được review.
- Permission rules: nhóm nào được quyền gì.
- Action rules: AI được tự động thực hiện việc gì.
- Human review: output/action nào phải có approval.
- Incident & review: báo sự cố cho ai và policy được review khi nào.
Khi policy được xây từ workflow thật, nó dễ áp dụng hơn rất nhiều so với một danh sách nguyên tắc chung chung.
Công thức có thể là:
Problem → Workflow → Data → Permission → Action → Control → Result.
Bảo mật ChatGPT Work là một workflow, không phải một checkbox
Câu hỏi kém hữu ích là:
“Có nên cho nhân viên dùng ChatGPT không?”
Câu hỏi hữu ích hơn là:
“Với job này, AI cần dữ liệu gì, cần quyền gì, được phép hành động đến đâu và checkpoint nào vẫn cần con người?”
Map lại thành:
JOB → DATA → ACCESS → ACTION → HUMAN CHECKPOINT → AUDIT

Thay vì bật hoặc cấm AI theo kiểu nhị phân, hãy thiết kế quyền và kiểm soát theo từng workflow và mức rủi ro.
Đó là điểm khác biệt giữa việc cho nhân viên “dùng một chatbot” và việc đưa AI vào một hệ thống làm việc có governance.
Câu hỏi thường gặp về bảo mật ChatGPT Work
ChatGPT Work có dùng dữ liệu doanh nghiệp để train AI không?
Theo chính sách OpenAI hiện hành, dữ liệu từ ChatGPT Business, Enterprise, Edu và các sản phẩm business được liệt kê không được sử dụng để huấn luyện model theo mặc định. Tuy nhiên, no-training không đồng nghĩa dữ liệu không được xử lý hoặc lưu để cung cấp dịch vụ. Với yêu cầu nhạy cảm, nên kiểm tra trực tiếp Business Data Privacy của OpenAI.
Admin ChatGPT có đọc được toàn bộ chat của nhân viên không?
Không nên mặc định rằng việc là Admin đồng nghĩa tự động nhìn thấy toàn bộ private chat của mọi thành viên. Quyền quản trị, managed account, compliance capability và access phụ thuộc workspace/plan. Nếu đây là vấn đề policy quan trọng, kiểm tra tài liệu managed ChatGPT account thay vì suy luận từ role name.
ChatGPT Business và Enterprise khác nhau thế nào về bảo mật?
Cả hai có các lớp bảo vệ business data, nhưng Enterprise cung cấp các capability quản trị và compliance sâu hơn cho tổ chức có yêu cầu phức tạp. Ví dụ có thể gồm Member RBAC, compliance logging, retention controls và các enterprise security control khác tùy thời điểm và eligibility.
Có nên đưa dữ liệu khách hàng lên ChatGPT không?
Không nên trả lời câu này bằng một “Có” hoặc “Không” áp dụng cho mọi doanh nghiệp. Hãy kiểm tra data classification, mục đích xử lý, workspace đang dùng, quyền truy cập, yêu cầu hợp đồng, privacy/legal requirement và policy nội bộ trước khi đưa customer data vào workflow.
ChatGPT kết nối Google Drive có nhìn thấy toàn bộ Drive không?
App với sync được OpenAI thiết kế để tôn trọng quyền hiện có của user ở nguồn dữ liệu. Tuy nhiên, admin vẫn cần review app enablement, authentication, nguồn được sync và capability read/write. Không nên dựa duy nhất vào giả định “connector tự động an toàn”.
Xóa nhân viên khỏi workspace thì dữ liệu của họ có bị xóa ngay không?
Không nhất thiết. Tài liệu OpenAI hiện hành phân biệt user removal với content deletion. Enterprise/Edu tuân theo retention policy đã cấu hình; ChatGPT Business hiện có behavior retention riêng. Vì vậy offboarding policy cần xử lý cả identity access lẫn data lifecycle.
Có cần human approval khi dùng AI Agent hoặc app có write action không?
Với các action có tác động đáng kể, human approval là một control hợp lý. Các ví dụ gồm publish, delete, gửi dữ liệu ra ngoài, thay đổi quyền hoặc cập nhật hệ thống production. Mức approval nên dựa trên hậu quả của action, không chỉ dựa trên việc action đó “do AI thực hiện”.
SME có cần AI governance không?
Có, nhưng không nhất thiết phải bắt đầu bằng framework enterprise phức tạp. Một data policy đơn giản, permission matrix, danh sách approved apps, action approval và Risk Register cho từng workflow đã là bước khởi đầu thực dụng hơn nhiều so với không có rule nào.
Bước tiếp theo: bắt đầu governance từ một workflow thật
Đừng bắt đầu bằng việc viết một policy 30 trang mà chưa biết team sẽ dùng AI để làm gì.
Hãy chọn một công việc đang chạy thật và map:
Input → Data → AI Process → Permission → Human Checkpoint → Output
Nếu muốn bắt đầu bằng Content SEO, bạn có thể xem GPT-AI Writer / Workflow Content SEO để thấy cách một quy trình AI nhiều bước được xây từ research đến output.
Nếu đang tìm workflow cho các bài toán khác, truy cập toàn bộ thư viện tài nguyên AIWorkflowFree.
Và nếu muốn xem các workflow được demo trực tiếp trước khi tự build, bạn có thể theo dõi kênh YouTube Duy Thìn.
Nguồn tham khảo
- OpenAI — Business data privacy, security, and compliance
- OpenAI — Enterprise privacy
- OpenAI — Security and privacy
- OpenAI — Data residency and inference residency for ChatGPT
- OpenAI — Managing members, seat types, and roles in ChatGPT Business
- OpenAI — Role Based Access Controls for ChatGPT Enterprise
- OpenAI — Apps in ChatGPT
- OpenAI — ChatGPT apps with sync
- OpenAI — Developer mode and MCP apps in ChatGPT
- OpenAI — Compliance Platform for Enterprise and Edu
- OpenAI — Data retention when a member is removed
- OpenAI — Chat and File Retention Policies in ChatGPT
